
一、資料集淘金與確認
在Kaggle搜尋過濾後,我排除了純心理健康相關的資料,鎖定了這份由學生與職場人士組成的專用數據集:
檔案名稱:digital_eye_strain_students_professionals.csv
資料規模:500筆樣本、13個變數
檔案大小:26.24 KB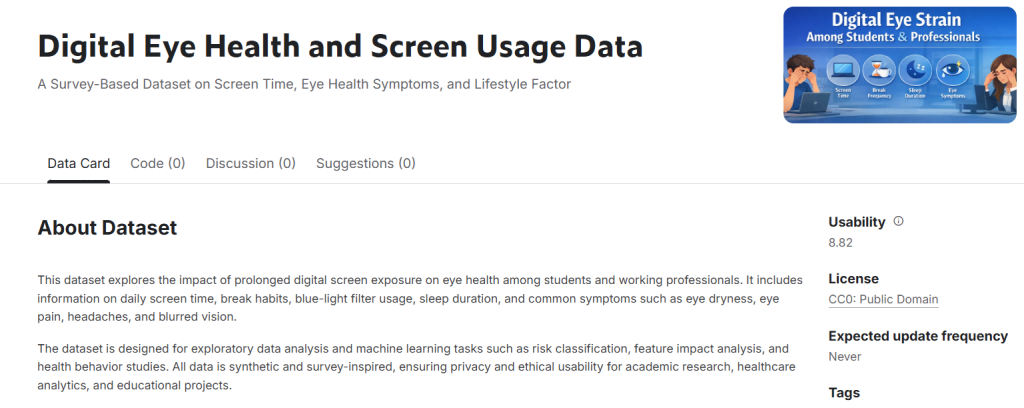
二、Colab讀取與第一手資料預覽
我直接將CSV檔上傳至Colab工作階段,並執行讀取檢查腳本:
import pandas as pd

# 讀取剛剛上傳的CSV檔案
file_name = 'digital_eye_strain_students_professionals.csv'
df = pd.read_csv(file_name)

# 1.檢查資料筆數與欄位數
print("=== 資料讀取成功 ===")
print(f"資料筆數: {df.shape[0]} 筆")
print(f"欄位數量: {df.shape[1]} 個")

# 2.印出所有原始英文欄位名稱
print("\n所有欄位名稱:")
print(df.columns.tolist())

# 3.預覽前5筆資料
df.head()
執行結果確認全部500筆樣本正常讀入,沒有出現編碼錯誤或欄位位移,資料預覽非常整齊。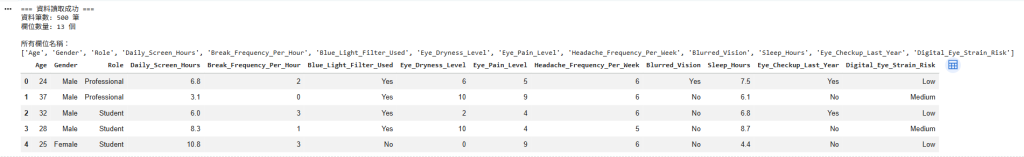
三、完整13欄位資料字典
檢視輸出的所有欄位名稱,我將這13個變數梳理並分類為四大維度,建立專案的資料字典: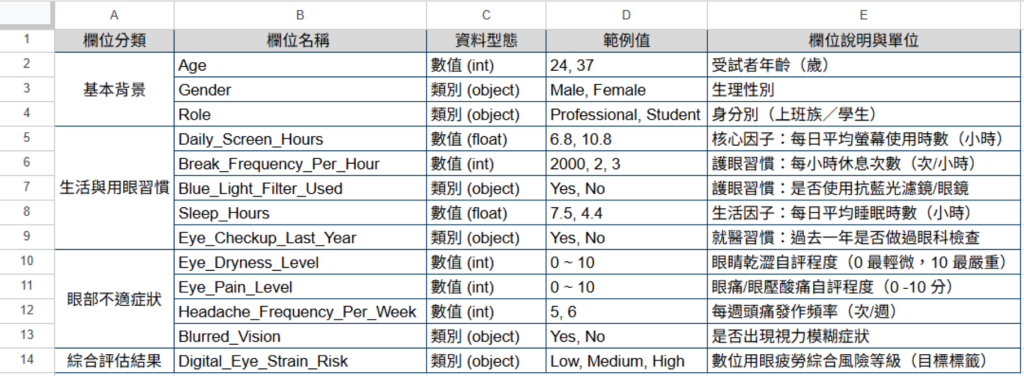
四、資料初探心得
這份資料集最棒的地方在於它的結構非常完整:
它同時具備了生活習慣自變數(螢幕時長、休息頻率、抗藍光)與生理症狀反應(乾眼、眼痛、頭痛、視力模糊)。
最後一欄Digital_Eye_Strain_Risk直接標記了風險等級(Low/Medium/High),這讓後續除了能做單純的相關性探索,還能在後期嘗試做簡易的邏輯斯迴歸(分類預測),探索哪些習慣是造成High Risk的最大元凶!
五、資料集來源與授權聲明


 iThome鐵人賽
 看影片追技術